
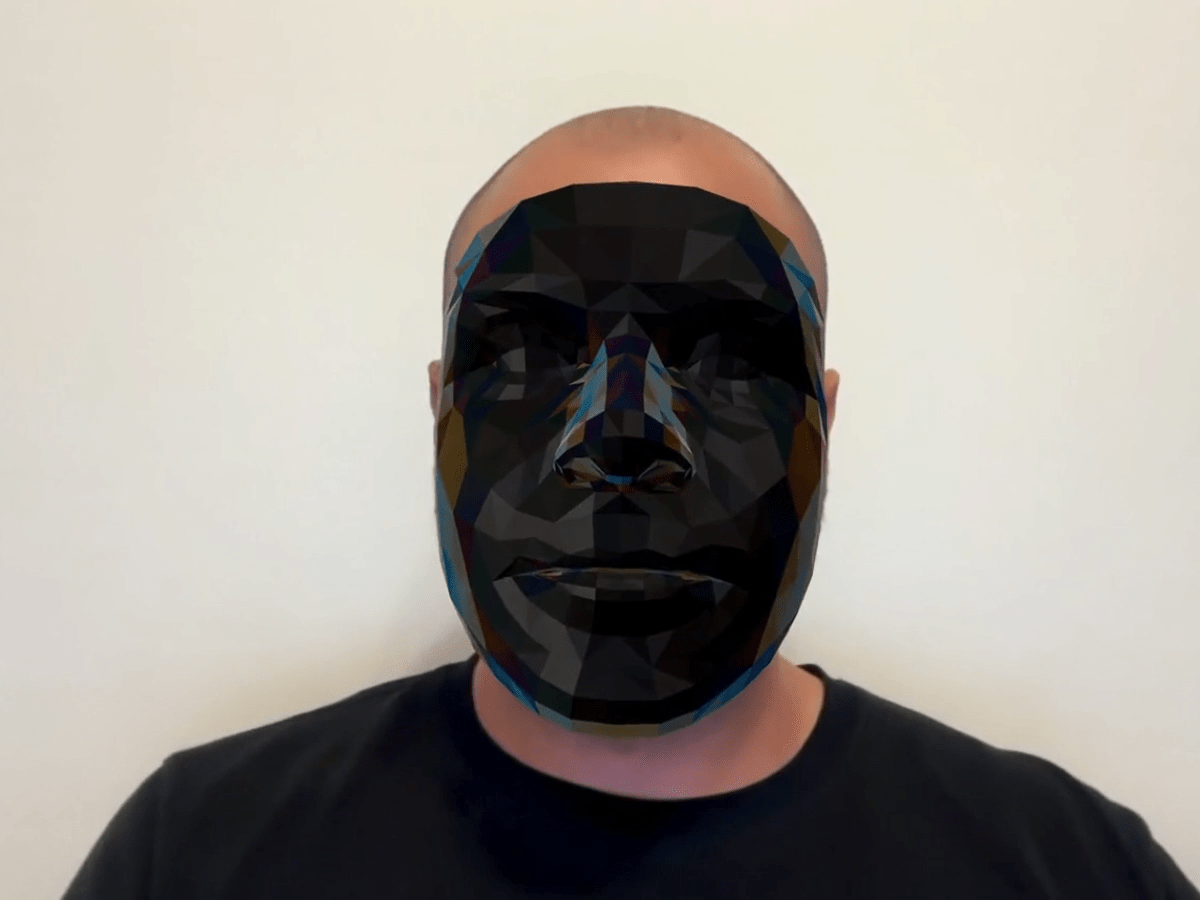

Примечание редактора: Поскольку наша конференция Three.js продолжается, мы особенно рады пролить свет на Марек Йозвяк сегодня. Марек был настолько великолепен, что представил это фантастическое руководство и демонстрацию, и его талант и внимание к деталям действительно проявились в этом исследовании MediaPipe, Threlte и Three.js. Мы очень рады, что его работа стала частью нашего праздника, и с нетерпением ждем, когда вы окунетесь в нее!
🎟️ Париж зовёт! Самая первая конференция Three.js приедет в Париж на два дня переговоров, идей и связей. Использовать код CODROPS для скидка 15% и получить билет →
Я начал этот эксперимент со скромной целью: нанести на лицо материал Three.js.
Первый прототип был менее убедительным, чем звучит это предложение. MediaPipe отслеживал лицо, но у Three.js по-прежнему не было поверхности для рендеринга. После того, как я предоставил топологию, сетка и зеркальное обрезанное видео разошлись по поводу кадрирования. Затем текстура оказалась перевернутой.
Эта последовательность стала фактическим предметом эксперимента: восстановление топологии фиксированного лица Google, перенос UV-изображений из канонической модели и проецирование результата в тот же вид, что и изображение с камеры. Инициализация MediaPipe и Three.js оказалась самой простой задачей.
От ориентиров до текстурированной сетки
Среда выполнения имеет два часа. MediaPipe анализирует видео и записывает последний результат в изменяемую ссылку. Threlte считывает эту ссылку внутри своей задачи рендеринга и изменяет существующую ссылку. BufferGeometry. Вывод может пропустить кадр рендеринга, не проталкивая 468 изменяющихся позиций через реактивный граф Svelte.
Сам слой камеры обычный. Детали, которые будут иметь значение позже, визуальны: в видео используется object-cover и является зеркальным, поэтому проекция, примененная к сетке, должна воспроизводить обе операции.
Я обернул MediaPipe в небольшой сервисный класс. Он разрешает файлы WASM Tasks Vision, загружает модель лица float16 и выбирает делегата графического процессора.
const VISION_BASE_URL = 'https://cdn.jsdelivr.net/npm/@mediapipe/tasks-vision@0.10.35/wasm';

const filesetResolver = await FilesetResolver.forVisionTasks(VISION_BASE_URL);

this.faceLandmarker = await FaceLandmarker.createFromOptions(filesetResolver, {
	baseOptions: {
		modelAssetPath:
			'https://storage.googleapis.com/mediapipe-models/' +
			'face_landmarker/face_landmarker/float16/1/' +
			'face_landmarker.task',
		delegate: 'GPU'
	},
	outputFaceBlendshapes: true,
	runningMode: 'VIDEO',
	numFaces: 1
});
Режим видео предполагает монотонно увеличивающуюся временную метку. performance.now() удобный источник:
startPrediction(videoElement: HTMLVideoElement) {
  const predict = () => {
    if (
      this.faceLandmarker &&
      videoElement.readyState >= 2
    ) {
      const results = this.faceLandmarker.detectForVideo(
        videoElement,
        performance.now()
      );

      this.landmarksRef.current = results;
    }

    this.requestRef = requestAnimationFrame(predict);
  };

  predict();
}
Я сохраняю результат в landmarksRefпростой объект, а не глубоко реактивный массив Svelte:
landmarksRef = { current: null };Ничто в DOM не должно перерисовываться при изменении 468 позиций. Three.js прочитает их во время собственного цикла обработки кадров. Сохранение этого горячего пути данных за пределами реактивного графа Svelte позволяет избежать необходимости запрашивать инфраструктуру пользовательского интерфейса для наблюдения за тысячами присвоений чисел в секунду.
Входящая в комплект модель возвращает 478 ориентиров. Эта сетка использует первые 468, поскольку они соответствуют канонической модели лица MediaPipe и ее фиксированной топологии. Остальные десять описывают радужную оболочку и не нужны для поверхности маски.
Это обеспечило стабильное положение ориентиров, но не поверхность. Мне все еще нужен был индексный буфер, описывающий, какие идентификаторы ориентиров образуют каждое лицо:
[
	127,
	34,
	139, // triangle 1
	11,
	0,
	37, // triangle 2
	232,
	231,
	120 // triangle 3
];
Порядок важен, поскольку он определяет намотку и, следовательно, какую сторону Three.js считает передней стороной.
Google уже опубликовал нужную мне топологию сетки лица. Я нашел сплющенный массив в Демонстрация распознавания ориентиров лица в репозитории моделей Google TensorFlow.js. Этот файл начинается с той же последовательности:
127, 34, 139,
11, 0, 37,
232, 231, 120,
Он содержит 2640 индексов или 880 треугольников. Я скопировал сглаженные данные в FaceTriangulation.ts и использовать его напрямую как FACE_MESH_TRIANGULATION.
Текущий репозиторий MediaPipe также публикует FACE_LANDMARKS_TESSELATION в API Python Face Landmarker. Он хранит связи, а не тройки треугольников. Его первые записи:
Connection(127, 34),
Connection(34, 139),
Connection(139, 127),

Connection(11, 0),
Connection(0, 37),
Connection(37, 11),
Таблица соединений кодирует те же открывающие треугольники, что и циклы замкнутых ребер. 127 → 34 → 139 → 127 становится [127, 34, 139]; 11 → 0 → 37 → 11 становится [11, 0, 37].
Представление TensorFlow.js более удобно для индексированного BufferGeometry потому что он уже расплющен в тройки треугольников. Наборы соединений MediaPipe остаются полезными, когда эффекту требуются именованные области, такие как глаза, губы или овал лица.
Оба репозитория публикуют соответствующий код под лицензией Apache 2.0.
После восстановления индекса я мог бы выделить геометрические буферы один раз:
const vertexCount = 468;
const indices = new Uint16Array(FACE_MESH_TRIANGULATION);
const positions = new Float32Array(vertexCount * 3);
const uvs = FACE_MESH_UVS;
Затем Threlte создает атрибуты буфера Three.js:
DynamicDrawUsage is a driver hint, not an update mechanism. The later position.needsUpdate = true marks the buffer for upload. Topology and UVs stay fixed; only the 468 XYZ positions are rewritten.
Wireframe mode is the best first test. A solid black material can hide bad topology surprisingly well, while a wireframe immediately shows disconnected vertices, a reversed face, or a badly scaled depth axis.
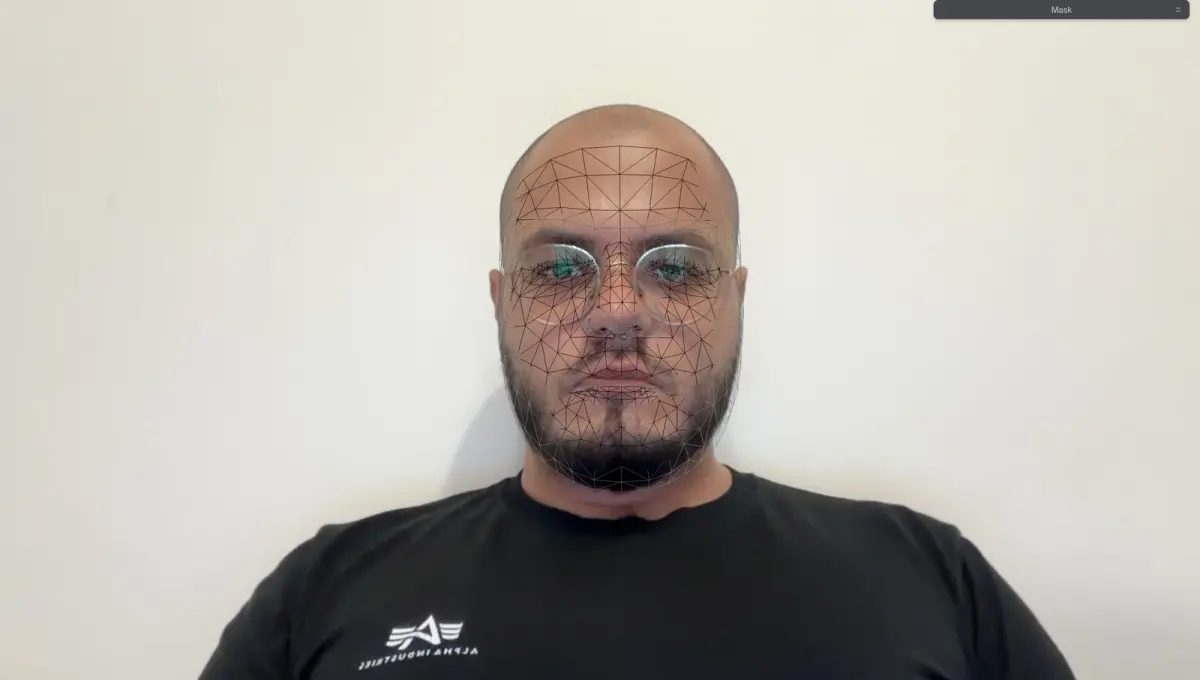
The triangle index solved connectivity. Texture mapping introduced a second indexing problem: the UV attribute still had to be reordered into the same 468-entry vertex order.
Google provides a canonical_face_model.obj in the MediaPipe repository. The Face Geometry documentation describes it as the bridge between a static asset and the runtime landmark set. The useful invariant here is the shared landmark index space: vertex 127 in the canonical asset corresponds to landmark 127 returned by the detector.
The same directory also contains Google’s canonical_face_model_uv_visualization.png. It is an excellent debug texture because its printed grid makes flipped or mismatched UVs obvious.

The OBJ contains:
- 468
vrecords for vertex positions; - 468
vtrecords for texture coordinates; - 898
frecords describing faces.
The counts reveal an important distinction between the two source files. The TensorFlow.js index has 880 triangles, while the canonical OBJ has 898 faces, and the face lists are not identical. I do not combine them. The runtime index comes entirely from triangulation.js; the OBJ is only used to recover the UV assigned to each of the 468 vertex IDs.
This is valid because a BufferGeometry index addresses every vertex attribute at once. Once the UV array is reordered to match the landmark positions, each selected triangle interpolates position and UV from the same three indices. The OBJ’s own f records are necessary during extraction because they reveal the vertex-to-UV mapping, not because they become the runtime index buffer.
The next problem was recovering the actual vertex-to-UV relation. The number of v and vt records happens to match, but their file order is not the mapping. OBJ face records carry that relationship explicitly:
f 174/43 156/119 134/220Here 174/43 means vertex 174 uses texture coordinate 43. OBJ indices are one-based, so both values are decremented before they address JavaScript arrays.
I wrote a small Node script to extract that relationship and generate a typed TypeScript array. Parsing an OBJ at runtime would make the demo heavier for no benefit because these UVs never change.
The input and output paths are resolved relative to the script, so it can be run from the project root with node scripts/extract-uvs.js:
const objPath = join(__dirname, '../src/lib/assets/models/canonical_face_model.obj');

const outputPath = join(__dirname, '../src/lib/utils/FaceUVs.ts');
The parser collects vt records, then resolves their relationship to vertices from each f token:
const textureCoords = []; const vertexToUV = новая карта(); for (const строка строк) { const Trimmed = line.trim(); if (trimmed.startsWith('vt ')) { const parts = Trimmed.split(/\s+/); const u = parseFloat(parts[1]); const v = parseFloat(parts[2]); текстураCoords.push([u, v]); } else if (trimmed.startsWith('f ')) { const parts = Trimmed.split(/\s+/).slice(1); for (const часть частей) { const index = part.split('/'); const vertexIdx = parseInt(индексы[0]) - 1; const uvIdx = parseInt(индексы[1]) - 1; if (!vertexToUV.has(vertexIdx)) { vertexToUV.set(vertexIdx, uvIdx); } } } }В этом каноническом файле все 468 вершин разрешаются ровно в один уникальный UV, поэтому отношение является биекцией. Сохранение первого назначения здесь безопасно, но это не универсальная стратегия OBJ: модель с UV-швами может назначить несколько координат текстуры одной геометрической вершине и должна дублировать эту вершину в буфере рендеринга.
После построения карты скрипт излучает UV-развертки в порядке ориентиров:
const uvArray = [];

for (let i = 0; i
Сгенерированный Float32Array содержит 936 значений, по два на каждую вершину, а 1.0 - v преобразование переворачивает вертикальную координату текстуры. Поскольку это переворачивание уже происходит в сгенерированных данных, я отключаю обычное переворачивание изображения Three.js при загрузке текстуры:
texture.flipY = false;
texture.colorSpace = THREE.SRGBColorSpace;
Отсутствие этих отношений дало мне перевернутую маску. Переворот UV-данных или текстуры — это нормально; переворачивать оба — нет.
Сопоставление сетки с камерой
Когда топология и UV были решены, следующее несоответствие было пространственным. MediaPipe возвращает нормализованные координаты, а сетка живет в мировых единицах Three.js.
Для перспективной камеры видимая высота на расстоянии d является:
const distance = camera.position.z;
const vFov = (camera.fov * Math.PI) / 180;
const height = 2 * Math.tan(vFov / 2) * distance;
const width = height * viewportAspect;
Если видео было растянуто до области просмотра, width и height было бы достаточно. Он использует object-coverпоэтому нам нужно воспроизвести это правило размера:
let scaleX = width;
let scaleY = height;

const videoAspect = videoElement.videoWidth / videoElement.videoHeight;
const screenAspect = viewportWidth / viewportHeight;

if (screenAspect > videoAspect) {
	scaleY = width / videoAspect;
} else {
	scaleX = height * videoAspect;
}
Если экран шире изображения камеры, object-cover подгоняет видео по ширине экрана и обрезает его по вертикали. В этом случае плоскость WebGL также должна стать выше. На относительно узком экране видео умещается по высоте и выходит за пределы горизонтали, поэтому плоскость WebGL становится шире.
Теперь каждый ориентир можно отобразить на видимой плоскости, сохраняя при этом относительную глубину MediaPipe:
const z = -landmark.z * scaleX * maskScale * depthScale + offsetZ;
const depthRatio = (distance - z) / distance;

const x = ((0.5 - landmark.x) * scaleX * maskScale + offsetX) * depthRatio;

const y = (-(landmark.y - 0.5) * scaleY * maskScale + offsetY) * depthRatio;
Вычитание 0.5 рецентры нормализованных координат. Знаки X и Y обозначают зеркальное видео и противоположные оси Y изображения/WebGL. Z следует за видимой шириной с отдельным множителем, поскольку глубина MediaPipe является относительной, а не измерением мирового пространства Three.js.
Значения X и Y MediaPipe уже являются координатами проецируемого экрана. Присвоение каждой вершине ненулевой позиции Z и последующая передача ее через перспективную камеру приведет к ее повторному проецированию, сместив ее от отслеживаемой позиции. Здесь камера зафиксирована на (0, 0, 5) и опорная плоскость z = 0поэтому умножив X и Y на (distance - z) / distance перемещает вершину вдоль того же луча камеры. Затем перспективная проекция возвращает его в отслеживаемое положение экрана, в то время как Z по-прежнему формирует нормали поверхности и освещение.
Масштаб и смещения отображаются в Tweakpane. Они полезны при разработке, особенно при тестировании различных веб-камер, но большую часть работы по выравниванию выполняет расчет аспектов.
После определения проекции Трелт useTask обратный вызов может записать текущие позиции ориентиров в существующий буфер. Он скрывает маску, когда лицо недоступно:
useTask(() => {
	if (!landmarkRef.current?.faceLandmarks?.length || !videoElement || !geometry || !mesh) {
		if (mesh) mesh.visible =...